TypeSafe ne remplace pas un agent qui rédige, planifie et agit à votre place. Son intérêt est plus précis : poser à Jev des questions étroites sur un état textuel, recevoir des sorties typées et laisser votre code décider de la suite.
Ce guide montre comment transformer cette primitive en workflow temps réel contrôlé, avec une mini-app de régie éditoriale qui classe des messages, mesure l’incertitude et route les cas vers un modérateur ou une revue humaine.
Fraîcheur : documentation TypeSafe et pages Jev vérifiées le 20 septembre 2026. Les alias, versions, limites, prix et surfaces d’accès peuvent évoluer ; la version retournée par l’API doit primer sur le nom d’alias utilisé dans le code.
Ce qu’il faut retenir
- System One répond à des questions structurées de type
Choice,ScoreouNoul; il ne produit pas le texte d’un agent et ne doit pas être confondu avec un orchestrateur. - Le bon découpage est : état textuel → questions indépendantes → seuils et règles déterministes → action ou revue humaine.
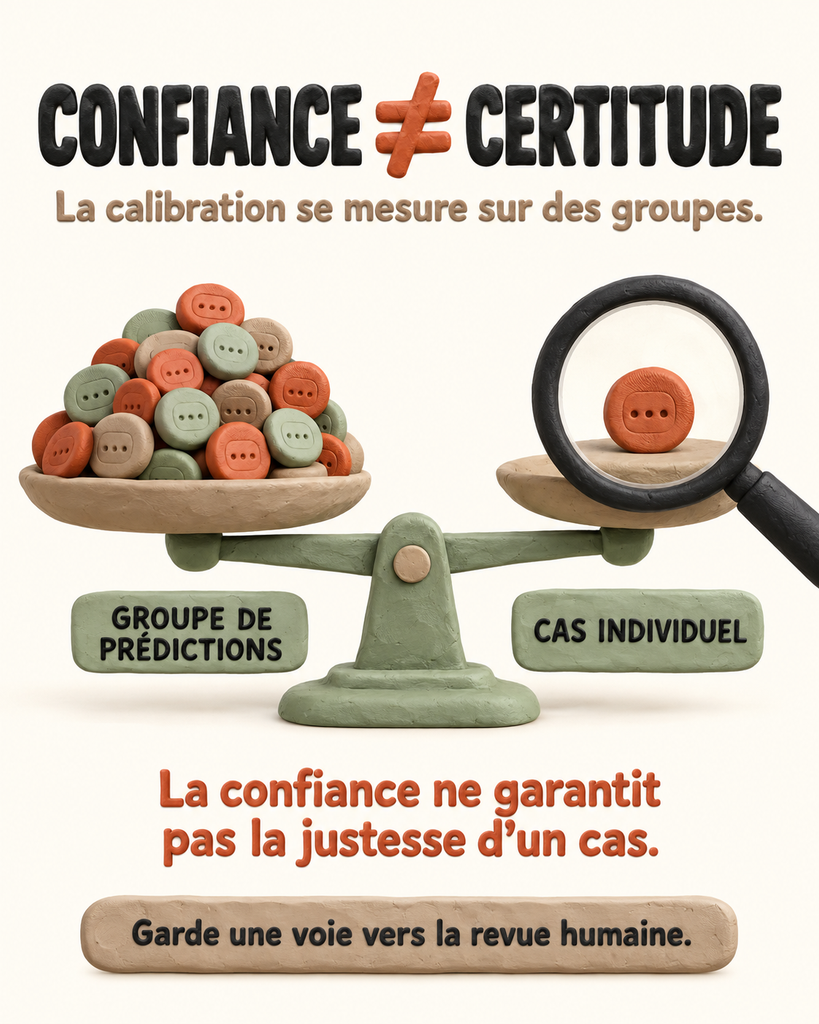
- Les questions parallèles rendent le workflow lisible, mais une confiance élevée ne garantit pas la justesse d’une décision individuelle.
- Dans le cas pratique, quatre décisions TypeSafe ont été réellement testées sur des messages de chat ; huit événements supplémentaires servent uniquement à densifier le replay visuel.
- La mini-app montre la régie en direct, mais ne fournit ni transport public, ni persistance, ni réponse automatique : ces briques restent à construire autour de l’API.
Jev n’est pas un agent : c’est une fonction de décision typée
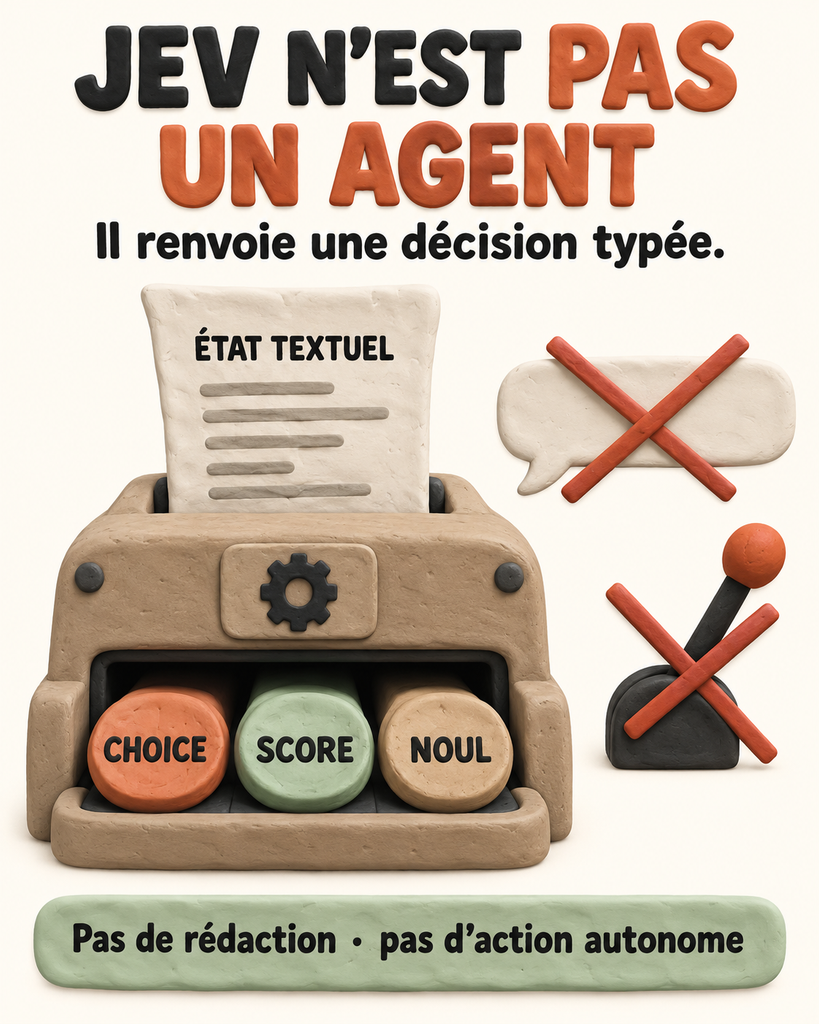
Le mot « agent » pousse facilement à donner trop de responsabilités au modèle. On lui demande un objectif, des outils, une mémoire, une boucle et une capacité d’action. System One part ailleurs : un état est fourni en entrée, plusieurs questions sont posées, puis une réponse structurée revient avec une valeur et, selon le type, des probabilités ou une confiance.
La documentation TypeSafe décrit Jev comme un modèle de décision pour les logiciels. Le résultat utile n’est donc pas une explication séduisante, mais une donnée que le programme peut comparer, journaliser et utiliser dans une branche. Pour un message de live, on peut demander : « quel est son type ? », « quel est son niveau d’urgence ? » et « quelle équipe doit le recevoir ? ». Le code conserve alors la responsabilité du seuil, de l’escalade et de la réponse visible.
Cette séparation est la mise à niveau importante de l’angle 1 : si le modèle choisit seul la prochaine action, on ne sait plus toujours pourquoi le workflow a bifurqué. Si Jev répond à des questions délimitées, l’architecture reste explicable : on voit l’état, les questions, les réponses, les probabilités disponibles et la règle qui a produit la route finale.
L’architecture d’un workflow TypeSafe
Un workflow fiable peut se décrire en huit étapes courtes :
- Capturer l’état. Conserver le texte original, son identifiant, son horodatage et les métadonnées nécessaires. Dans notre cas, l’état est le message de chat.
- Définir des questions étroites. Une question correspond à une décision utile au code, pas à une demande vague de résumé.
- Choisir un type.
Choicesert à sélectionner une classe,Scoreà positionner une intensité selon une légende, etNoulà tester une propriété. - Paralléliser les branches indépendantes. Le type de message, l’urgence et la route peuvent être demandés dans le même appel puisqu’ils observent le même état.
- Journaliser la réponse brute. Conserver le modèle retourné, les réponses, les probabilités disponibles, la confiance, les temps affichés et l’identifiant de l’événement.
- Appliquer une politique déterministe. Le seuil de 75 % utilisé dans la démo est une règle de cas pratique, pas une recommandation universelle. Un score sous le seuil déclenche la revue humaine.
- Rendre une route visible. Le système peut envoyer vers un modérateur, un community manager, une file d’attente ou une revue manuelle ; il ne répond pas automatiquement par défaut.
- Mesurer et corriger. Les décisions contestées deviennent des exemples de calibration. Il faut distinguer erreur du modèle, question mal formulée, seuil trop strict et erreur de code.
Ce découpage protège aussi la réversibilité. Changer Jev ou une question ne doit pas réécrire le transport, la base d’événements ou les permissions de l’équipe. Le modèle est une brique de décision dans une chaîne plus large.
Ce que la documentation permet réellement
Le Quick start officiel documente un appel POST vers https://api.typesafe.ai/v1/systemone, avec un état, un modèle et un objet questions. L’exemple utilise jev-latest et mélange Choice, Score et Noul. La réponse d’exemple expose une version résolue, jev-1.13.0, ainsi que les réponses et l’usage de tokens.
La page Models indique que l’alias jev-latest peut évoluer. Il faut donc enregistrer le champ model renvoyé par la réponse, et non déduire la version à partir du code source. La même page présente Jev comme un modèle texte ; elle ne justifie pas l’envoi direct d’audio, d’image ou de vidéo. Dans un live audiovisuel, le workflow doit recevoir une transcription ou des sous-titres déjà produits par une autre brique.
Cas pratique : Signal Room, une régie éditoriale en temps réel
Signal Room : rendre le traitement visible
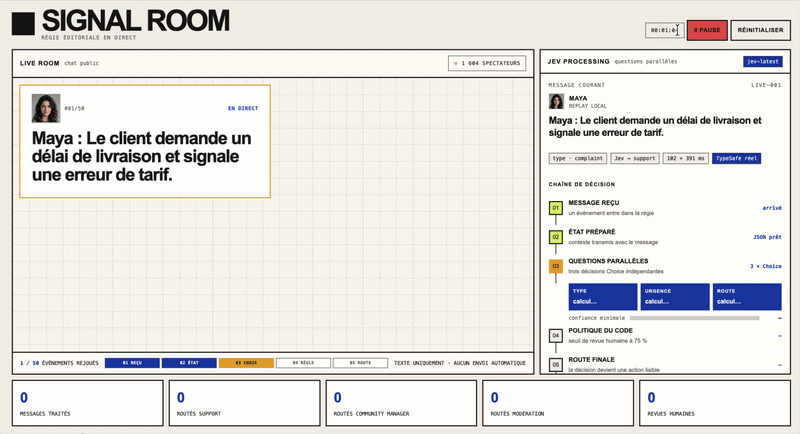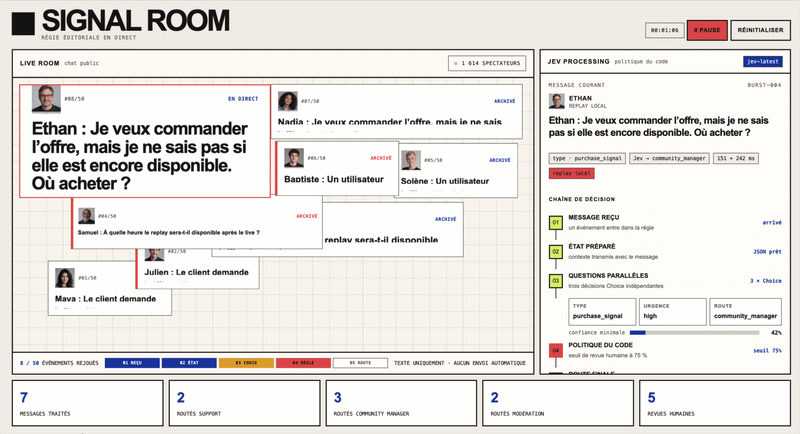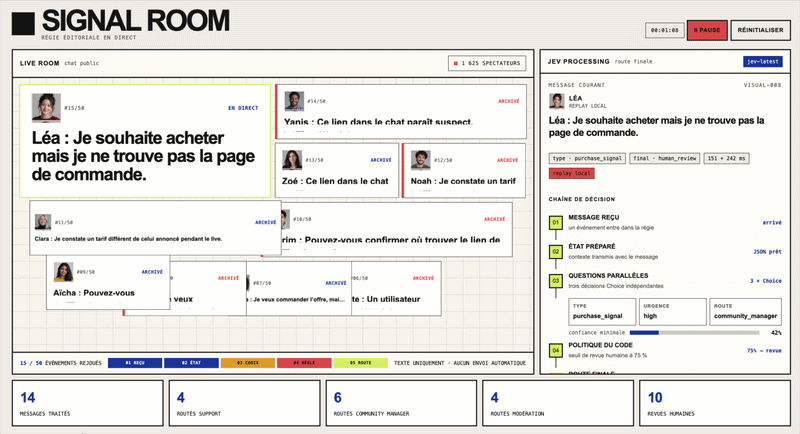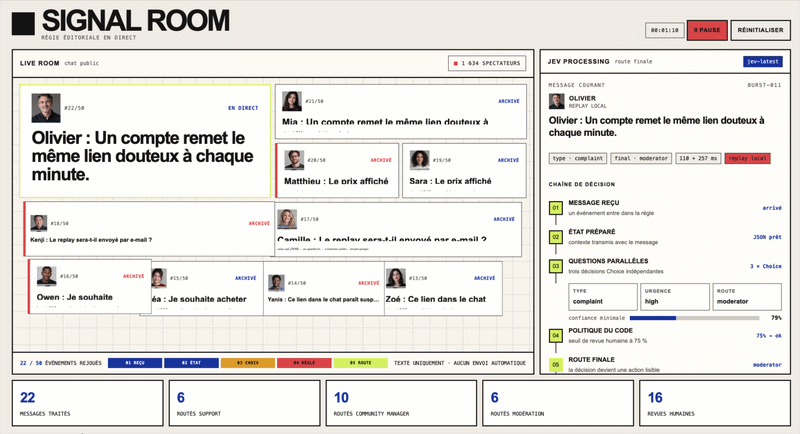
La mini-app Signal Room transforme ce workflow en régie éditoriale observable.
Le live démarre automatiquement. Chaque message apparaît dans une grille ON AIR, puis avance dans une chaîne de décision visible : réception, préparation de l’état, questions parallèles, politique du code et route finale.
Les quatre premiers événements correspondent aux décisions réellement testées dans TypeSafe. Quarante-six messages visuels supplémentaires servent à accélérer le replay et à montrer le comportement de l’interface à plus grande échelle.
La démonstration répartit les messages entre support, community management et modération, tout en conservant les cas nécessitant une revue humaine.
L’objectif est de surveiller un chat live sans laisser un modèle publier ou répondre automatiquement. Chaque message entre dans une régie qui l’analyse, mesure son niveau d’incertitude et propose une route. Le code conserve ensuite le contrôle de la décision finale.
Le workflow repose sur trois questions typées :
| Question | Type | Valeurs utilisées |
|---|---|---|
message_type | Choice | complaint, question, purchase_signal, praise |
urgency | Choice | low, medium, high |
route | Choice | moderator, community_manager, support |
La règle est volontairement simple et visible : si la confiance minimale des trois réponses est inférieure à 0.75, le message est envoyé vers human_review. Lorsque cette confiance atteint le seuil, la route proposée par Jev est conservée.
Ce seuil ne mesure pas la qualité générale du modèle. Il définit un point de contrôle opérationnel : en dessous de 75 %, un humain doit vérifier la décision avant toute action.
Les quatre décisions testées
Quatre messages synthétiques ont été envoyés dans le Playground TypeSafe avec le modèle affiché jev-latest. La version résolue par le Playground n’était pas visible dans l’interface ; elle n’est donc pas déduite ou inventée ici.
Les temps affichés sont conservés tels quels. Ils ne sont pas présentés comme des latences p50, p95 ou comme des temps de génération, car leur signification précise n’était pas documentée.
| Événement | Décision structurée | Confiance minimale | Route retenue | Temps affichés |
|---|---|---|---|---|
live-001 | plainte / haute / support | 57 % | revue humaine | 102 + 391 ms |
live-002 | question / moyenne / community manager | 56 % | revue humaine | 174 + 172 ms |
live-003 | plainte / haute / modérateur | 79 % | modérateur | 110 + 257 ms |
live-004 | signal d’achat / haute / community manager | 42 % | revue humaine | 151 + 242 ms |
Le résultat est intéressant parce qu’il ne cherche pas à maximiser l’automatisation. Une seule décision peut être routée directement ; les trois autres restent soumises à une revue humaine.
Dans une équipe réelle, il faudrait comparer ces routes avec les décisions humaines finales, mesurer les faux positifs et les faux négatifs, puis recalibrer le seuil sur un volume de messages plus large.
Ce que ce cas permet de vérifier
Ce cas pratique montre quatre principes utiles :
- une décision générée par un modèle peut rester structurée et vérifiable ;
- une règle applicative peut imposer un seuil de revue humaine ;
- le code peut séparer la prédiction du modèle de l’action réellement autorisée ;
- l’interface peut rendre visibles l’incertitude, la route et l’historique.
Le modèle ne répond pas directement au public. Il produit une décision structurée. Le code choisit ensuite si cette décision peut être suivie, si elle doit être routée vers une équipe ou si elle nécessite une validation humaine.
Méthodologie et limites
Le test porte sur quatre messages synthétiques envoyés dans le Playground TypeSafe. La mini-app est un replay local enrichi de messages visuels ; elle ne constitue pas un flux live connecté en permanence à TypeSafe.
Pour transformer ce prototype en service, il faudrait ajouter une file d’entrée, une déduplication, une persistance des décisions, une gestion des erreurs réseau, une limitation de débit et une interface permettant à un humain de corriger la route sans supprimer la décision originale.
5 use cases à construire autour du même pattern
Le cas de la régie éditoriale n’est qu’un point de départ. Les idées suivantes ne sont pas des fonctionnalités annoncées de TypeSafe : ce sont des scénarios à construire autour de la même mécanique — état textuel, questions typées, politique déterministe et action visible.
Le radar de crise de marque.
Les signaux textuels d’un chat, d’un formulaire ou d’un brief sont évalués selon risque, niveau d’escalade et propriétaire. La démonstration wow est un mur de trois voies : répondre, surveiller, réunir une cellule humaine.
Le script supervisor d’un tournage.
Les notes de plateau et transcriptions sont transformées en décisions de continuité : plan à vérifier, accessoire incohérent, réplique à reprendre. Le code rattache chaque alerte à un plan et conserve la validation du chef de plateau.
Le brief créatif qui se met en scène en direct.
Chaque nouvelle contrainte est classée comme direction artistique, contrainte de production, demande client ou contradiction. L’interface montre le brief se recomposer et met en évidence les décisions qui exigent un arbitrage humain.
Le radar d’un lancement produit en live.
Les questions et réactions sont réparties entre signal d’achat, objection, demande support et bruit. La scène wow est une carte qui fait monter les objections récurrentes et route chaque cas vers la bonne équipe.
Le répartiteur de modèles et de compétences.
Une demande entrante est décrite par son objectif, sa sensibilité et son besoin d’outil. TypeSafe/Jev décide d’une catégorie structurée ; le code choisit ensuite le modèle, le skill ou la revue humaine appropriée.
Dans les cinq scénarios, la promesse doit rester testable : conserver l’entrée, la version des questions, la réponse brute, la décision du code et la correction humaine. Ce sont des pistes de conception, non des résultats mesurés dans ce guide.
Faire du temps réel sans confondre vitesse et fiabilité
Un live visible donne envie d’optimiser l’intervalle entre deux messages. Pourtant, la première métrique utile n’est pas une vitesse isolée : c’est le temps entre l’arrivée du message et une décision exploitable, avec le taux de revue, le taux de correction humaine et la perte de contexte. Les temps observés dans le Playground sont des traces de cette exécution particulière, pas un benchmark.
Pour passer du replay à un service, ajoutez progressivement :
- une file d’entrée avec identifiant et horodatage monotone ;
- une couche de déduplication pour les messages répétés ou corrigés ;
- un cache de réponses et une stratégie de reprise en cas d’échec réseau ;
- un stockage des questions, de la version Jev retournée et de la décision humaine finale ;
- une limite de débit et une file de priorité pour les messages à risque ;
- une interface de correction qui permet de remplacer la route sans effacer la réponse originale.
Le live doit également avoir un état de secours. Si TypeSafe devient indisponible, le code doit pouvoir maintenir le message en revue humaine ou appliquer une règle minimale documentée. La panne ne doit pas devenir une publication automatique par défaut.
Méthodologie et limites
Les pages officielles TypeSafe documentent System One, les types de questions, l’endpoint, l’exemple de payload, le SDK Python et la réponse versionnée. Elles décrivent Jev comme une brique texte de décision structurée. Les limites de prix, de contexte et de débit doivent être relues avant intégration, car elles peuvent changer.
Aucun test de charge, de disponibilité, de coût réel, de persistance ou de contenu audio/vidéo brut n’a été réalisé. La version résolue par le Playground n’a pas été affichée. Il faut aussi tester les messages français de votre propre activité avant de conclure sur la qualité.
Pour prolonger ce travail, la formation IA agentique : du brief à l’automatisation est la plus pertinente : elle traite le passage du brief à un workflow agentique avec missions, compétences, prototype et validations humaines. Elle ne remplace pas la documentation TypeSafe ; elle aide à organiser la méthode et les garde-fous autour de l’outil.
Le sujet se raccorde aussi à ChatGPT Work et les workflows créatifs, à la méthode du règlement pour un agent IA et à la mémoire d’agence face aux prompts dispersés. Ces articles traitent l’orchestration et la gouvernance ; celui-ci se concentre sur la décision typée et son routage code-first.
Sources et références
Sources officielles TypeSafe consultées le 20 septembre 2026 :
- How to build with System One — principes de conception, état, questions et décisions structurées.
- Quick start TypeSafe — Playground, endpoint, payload, SDK Python et réponse d’exemple.
- System One — distinction entre décision typée et génération de texte.
- Models — alias, version Jev, limites et périmètre texte à revalider.
- Introducing System One models and Jev — annonce de TypeSafe, présentée comme telle et non comme un benchmark indépendant.

AUTEUR
Fondateur de CreativeAI.fr · Expert IA & workflows créatifs · 20+ ans d’expérience en direction créative (Marcel, Leo Burnett). 600+ professionnels formés depuis 2023 aux usages, méthodes et workflows IA. 4,7/5 de satisfaction moyenne.
Guides Pratiques & outils
Brand Brain : transformer une stratégie de marque en système IA
Un Brand Brain IA est un référentiel de marque structuré pour être consulté, interprété et vérifié par des assistants IA. Il ne s’agit pas de copier un brand book dans une conversation ni d’empiler des prompts.
Google Flow & Gemini : construire un studio créatif IA complet
Workflow, Agent, Tools, crédits et 100 prompts pour produire, éditer et industrialiser des vidéos IA. MAJ
ChatGPT Images 2.5 : du croquis au mini-kit de marque cohérent
On ne prompte plus, on spécifie. L’image devient une structure sémantique que le modèle compose, édite et révise. Le prompt cesse d’être une invocation, il devient une architecture.
formation IA
Google Flow, Veo & Gemini Omni : L’Orchestration Cinématographique IA
Durée : 2 jours (14h). Public : DA, réalisateurs, motion designers, équipes marketing, communication et social media
Réinventer son processus créatif avec l’IA générative
Durée : 5 jours (35h). Public : DA, graphistes, designers
Créer des visuels de marque avec ChatGPT Images et Codex NEW
Durée : 1 jour (7h). Public : directeurs artistiques, équipes marketing et communication, agences, studios et équipes de contenu
Claude Cowork & Skills : construire des assistants IA métier NEW
Durée : 2 jours (14h). Public : Responsables de production et dirigeants de structures créatives, équipes marketing, communication et contenu, agences et studios créatifs
Social Content Factory : produire et décliner ses contenus avec l’IA NEW
Durée : 2 jours (14h). Public : Responsables marketing et communication, Social media managers et content managers, Agences, studios et équipes éditoriales
IA agentique pour les créatifs : du brief à l’automatisation NEW
Durée : 1 jour (7h). Public : Responsables de production et dirigeants de structures créatives, équipes marketing, communication et contenu, agences et studios créatifs